Herausforderungen bei der Verwaltung großer Datenarchive
Unternehmen und Forschungseinrichtungen stehen heute vor einer fundamentalen Herausforderung: Es geht nicht mehr nur darum, wachsende Datenmengen irgendwo abzulegen — sondern darum, sie über Jahrzehnte hinweg auffindbar, zugänglich und nutzbar zu halten.
Ob Medienproduktion, Energie-exploration, wissenschaftliche Forschung, Gesundheitswesen oder Automotive — in nahezu allen Branchen entstehen jedes Jahr Petabytes an Daten, die langfristig verfügbar bleiben müssen: für Compliance, Wiederverwendung, KI-Training und operative Kontinuität.
Effizientes Archivmanagement ist damit längst keine rein technische Disziplin mehr, sondern eine strategische IT-Aufgabe mit direktem Einfluss auf Wettbewerbsfähigkeit und Innovationsfähigkeit.
Thema: Verwaltung großer Datenarchive und Langzeitdatenspeicherung
Dieser Artikel behandelt zentrale Technologien, Use Cases und Lösungskonzepte für skalierbare Archivspeicher und intelligentes Datenmanagement im Unternehmensumfeld.
Technologie-Konzepte
- Datenarchivierung
- Active Archive
- Tape Storage
- Langzeitdatenspeicherung
- Archivmanagement
- Metadatenindexierung
- Datenkataloge
IT-Infrastruktur
- High Performance Computing (HPC)
- Cloud- und Hybrid-Speicher
- Hybrid-Storage-Architekturen
- verteilte Speicherbibliotheken
Anwendungsbereiche
- wissenschaftliche Forschung & HPC
- Medien- und Entertainmentproduktion
- Öl-, Gas- und Energieexploration
- Gesundheitswesen & medizinische Bildgebung
- Nationale Sicherheit & staatliche Archive
- Finanzdienstleistungen
Zentrale Herausforderungen
- Datenauffindbarkeit und Dark Data
- Skalierbarkeit von Exabyte-Archiven
- Datenintegrität über Jahrzehnte
- Nahtlose Integration mit KI- und HPC-Plattformen
Ablösung proprietärer Archivstrukturen ohne aufwendige physische Datenmigration
Kompakte Kombination aus Pain-Point und Lösung:
Pain-Point: Proprietäre Archivformate binden Unternehmen langfristig an Legacy-Systeme und machen einen Plattformwechsel teuer, langsam und riskant.
Lösung: Durch eine Metadatenmigration können vorhandene Archivdaten in einer neuen Lösung zugänglich gemacht werden, ohne die Daten physisch vollständig migrieren zu müssen. Legacy-Archive modernisieren, ohne Petabytes zu verschieben.
Wie das in der Praxis aussieht, zeigt Versity ScoutAM: Das Deutsche Klimarechenzentrum hat damit laut Versity ein Archiv mit 254 PB ohne Datenmigration übernommen.
Verwaltung großer Datenarchive
Definition
Die Verwaltung großer Datenarchive umfasst die Organisation, Speicherung, Indexierung und langfristige Sicherung großer Datenmengen — mit dem Ziel, diese über viele Jahre oder Jahrzehnte hinweg zugänglich, integer und nutzbar zu halten. Moderne Ansätze verbinden kosteneffiziente Speichertechnologien wie Tape mit intelligenten Metadatenkatalogen und offenen S3-Schnittstellen.
Typische Herausforderungen
- Schnelles Auffinden archivierter Datensätze in Petabyte- bis Exabyte-Archiven
- Zentrale Verwaltung verteilter Speicherbibliotheken mit Tausenden von Bändern
- Nahtlose Integration bestehender Archive in moderne KI-, HPC- und Cloud-Workflows
- Langfristige Sicherstellung von Datenintegrität und -lesbarkeit ohne Vendor-Lock-in
- Skalierung der Archiv-Infrastruktur ohne kostspielige Datenmigration
Typische Lösungsansätze
- Skalierbare Archivmanagementplattformen mit policy-gesteuerter Datenhaltung
- Leistungsstarke Metadatenindexierung für sekundenschnelle Suche im Exabyte-Bereich
- Automatisierte Daten-Tiering-Prozesse zwischen Flash, Object Storage, Cloud und Tape
- Offene Speicherarchitekturen auf Basis von S3-Gateways und Open-Source-Formaten
Welche Probleme entstehen bei der Verwaltung großer Datenarchive?
Große Datenarchive mit Petabytes oder Exabytes an Daten verursachen typischerweise Probleme bei der Auffindbarkeit, der zentralen Bibliotheksverwaltung und der langfristigen Datenintegrität. Hinzu kommt die Anforderung, historische Archive ohne Datenmigration in moderne KI- und HPC-Umgebungen zu integrieren. Skalierbare Archivmanagementplattformen mit offenen Metadatenformaten, policy-gesteuertem Daten-Tiering und S3-kompatiblen Schnittstellen lösen diese Herausforderungen effizient.
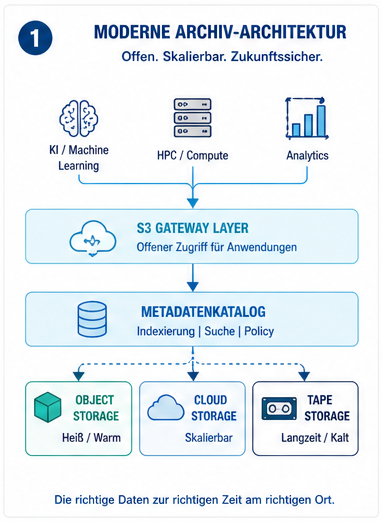
Image 1: Moderne Archiv-Architektur.
Was ist Datenarchivierung im Unternehmen?
Unternehmensarchivierung bezeichnet die strukturierte, langfristige Speicherung großer Datenmengen in kosteneffizienten, skalierbaren Speichersystemen — bei gleichzeitiger Gewährleistung von Zugänglichkeit, Suchbarkeit und Datenintegrität über Jahre oder Jahrzehnte hinweg.
Typische Use Cases und archivierte Datentypen:
- Wissenschaftliche Simulationsdaten und HPC-Checkpoints (z. B. Klimamodellierung, Genomsequenzierung)
- Medienarchive: hochauflösende Video-Masters, Rohschnitte und Broadcast-Content
- Medizinische Bilddaten: MRT, CT-Scans, Pathologiedaten für Langzeitdokumentation
- Seismische und geologische Messdaten aus der Energie- und Rohstoffexploration
- Compliance- und Finanzdaten mit gesetzlichen Aufbewahrungsfristen
Das Ziel: Daten bleiben über den gesamten Lebenszyklus zugänglich — von der Erst-Erstellung bis zur Wiederverwendung in KI-Analysen Jahrzehnte später.
Warum Langzeitdatenspeicherung heute geschäftskritisch ist
Das Datenwachstum verändert die Spielregeln in nahezu jeder Branche — und macht effizientes Archivmanagement zur strategischen Notwendigkeit.
Treiber des Datenwachstums:
- KI-Modelltraining und maschinelles Lernen erzeugen und benötigen massenhaft historische Datensätze
- Wissenschaftliche Großprojekte (Teilchenphysik, Astronomie, Genomik) produzieren Exabytes pro Jahr
- 4K/8K-Videoproduktion und Streaming-Plattformen treiben Mediendatenmengen exponentiell
- Regulatorische Anforderungen (DSGVO, GoBD, FDA 21 CFR Part 11) verlängern Aufbewahrungsfristen
Wer diese Daten nicht aktiv und strukturiert archiviert, verliert den Zugriff auf wertvolle Informationen — und damit Innovationspotenzial, Compliance-Sicherheit und Kostenkontrolle.
Moderne Archivplattformen verbinden kosteneffiziente Massenspeicherung (Tape, Object Storage, Cloud) mit intelligentem Daten-Tiering und offenen Schnittstellen für maximale Interoperabilität.
Herausforderung 1: Zentrale Verwaltung großer Speicherbibliotheken
Wer kennt das Problem? Ein Medienunternehmen betreibt mehrere Tape-Bibliotheken an verschiedenen Standorten. Niemand weiß mehr genau, welches Band welchen Content enthält — und das Abrufen einer Datei dauert Stunden statt Sekunden.
- Typische Dimensionen gewachsener Archivlandschaften:
- Zehntausende Speicherbänder verteilt über mehrere Bibliotheken und Standorte
- Petabytes bis Exabytes an unstrukturierten Daten ohne einheitlichen Datenkatalog
Historisch gewachsene Silo-Systeme unterschiedlicher Hersteller ohne gemeinsame Verwaltungsebene
- Die Folgen fehlender zentraler Verwaltung:
- Keine verlässliche Übersicht über gespeicherte Datensätze und Speicherkapazitäten
- Ineffiziente Speichernutzung und unkontrolliertes Datenwachstum ohne Kostentransparenz
Manuelle Archivverwaltung ist bei dieser Skalierung weder wirtschaftlich noch zuverlässig. Eine zentrale Managementplattform, die alle Bibliotheken, Speicher-Tiers und Standorte in einer einheitlichen Ansicht zusammenführt, ist die einzig skalierbare Antwort.
Herausforderung 2: Archivierte Daten schnell und zuverlässig finden
Ein Forschungsteam benötigt Simulationsdaten aus einem Projekt von vor fünf Jahren — aber die Suche im Archivsystem liefert kein Ergebnis. Die Daten sind vorhanden, aber nicht auffindbar. Das ist Dark Data.
Ursachen mangelhafter Auffindbarkeit:
- Fehlende oder inkonsistente Metadaten bei der Archivierung
- Keine durchgängige Indexierung über alle Speichertier und Bibliotheken hinweg
- Proprietäre Suchschnittstellen ohne Integration in bestehende Datenportale
Dark Data — archivierte, aber faktisch unnutzbare Daten — ist kein technisches Nischenproblem, sondern ein realer wirtschaftlicher Schaden: verschwendete Speicherkapazität, duplizierte Forschungsarbeit und verpasste Chancen bei der Datenwiederverwertung für KI-Anwendungen.
Herausforderung 3: Integration in KI-, HPC- und Cloud-Workflows
Moderne Datenplattformen setzen Kompatibilität voraus — aber viele historische Archive sprechen eine andere Sprache.
- Typische Umgebungen, in die Archive integriert werden müssen:
- KI- und Machine-Learning-Pipelines, die auf Exabytes historischer Trainingsdaten zugreifen
- HPC-Cluster mit parallelen Dateisystemen (Lustre, GPFS) für rechenintensive Simulationen
- Cloud-Plattformen (AWS S3, Azure Blob, Google Cloud Storage) für flexible Skalierung
Eine Archivplattform mit offenem S3-Gateway und nativer Unterstützung für gängige HPC-Dateisysteme eliminiert Medienbrüche — und ermöglicht es, historische Archive direkt in KI-Trainingspipelines oder wissenschaftliche Analyseworkflows einzubinden, ohne kostspielige Datenmigration.
Herausforderung 4: Skalierung auf Exabyte-Niveau ohne Betriebsunterbrechung
Datenwachstum kennt keine Pause — und ein Archivsystem, das bei wachsenden Anforderungen immer neue Migrationsprojekte erzwingt, wird zum Engpass statt zur Lösung.
Die Antwort: modulare Archivplattformen, die kapazitäts- und performanceseitig inkrementell erweiterbar sind — ohne Migrationsprojekte, ohne Vendor-Lock-in, ohne Betriebsunterbrechung. Hardware-agnostische Architekturen auf Basis offener Standards sichern Investitionsschutz über Technologiegenerationen hinweg.
Herausforderung 5: Langfristige Datenintegrität über Jahrzehnte
Für einen Energiekonzern sind seismische Bohrloch-Daten aus den 1990er Jahren plötzlich wieder relevant — doch beim Auslesen zeigen sich stille Fehler durch Bitrot. Die Daten sind da, aber nicht mehr vertrauenswürdig.
Ein robustes Archivsystem muss sicherstellen, dass Daten:
- langfristig auf aktuellen und zukünftigen Medien lesbar bleiben (regelmäßige Tape-Refreshes)
- durch kryptographische Checksummen aktiv vor unbemerkte Datenkorruption (Bitrot) geschützt sind
- in offenen Metadatenformaten gespeichert sind, die unabhängig von proprietärer Software lesbar bleiben
Definitionsbibliothek
Datenarchivierung – Langfristige, kosteneffiziente Speicherung großer Datenmengen in spezialisierten Archivsystemen — mit Fokus auf Integrität, Zugänglichkeit und Skalierbarkeit über Jahre und Jahrzehnte.
Active Archive – Ein Archivsystem, das über die reine Datensicherung hinausgeht: Es ermöglicht direkten Zugriff, leistungsstarke Suche und nahtlose Integration in aktive Analyse- und KI-Workflows — ohne Daten in teurere Primärspeicher zurückspielen zu müssen.
Metadatenindexierung – Die strukturierte, automatisierte Erfassung beschreibender Informationen über Datensätze zum Zeitpunkt der Archivierung — Grundlage für schnelle, zuverlässige Suche in Exabyte-großen Archiven.
Langzeitdatenspeicherung – Die sichere Aufbewahrung von Daten über viele Jahre oder Jahrzehnte, unter Gewährleistung von Lesbarkeit, Integrität und Vendor-Unabhängigkeit — typischerweise realisiert mit energie-effizienten Tape-Technologien und offenen Dateiformat-Standards.

Image 2: Traditionell vs. Active Archive
Wichtigste Erkenntnisse
- Exabyte-Archive erfordern zentrale Managementplattformen mit einheitlichem Datenkatalog über alle Standorte und Speicher-Tiers.
- Leistungsstarke Metadatenindexierung ist der entscheidende Faktor, um Dark Data zu verhindern und archivierte Daten für KI-Anwendungen nutzbar zu machen.
- Offene S3-Schnittstellen und hardware-agnostische Architekturen ermöglichen die Integration historischer Archive in moderne HPC-, KI- und Cloud-Umgebungen ohne Datenmigration.
- Langfristige Datenintegrität durch aktives Integrity-Monitoring und offene Metadatenformate ist die Grundvoraussetzung für compliance-sichere Langzeitarchivierung.
Häufig gestellte Fragen zur Datenarchivierung (FAQ).
Was ist Datenarchivierung im Unternehmenskontext?
Datenarchivierung bezeichnet die strukturierte, langfristige Speicherung großer Datenmengen in kosteneffizienten Speichersystemen — typischerweise Tape, Object Storage oder Hybrid-Cloud-Architekturen. Ziel ist es, Daten über viele Jahre hinweg sicher aufzubewahren, gleichzeitig schnell auffindbar zu halten und ihre Integrität zu gewährleisten.
Warum ist die Verwaltung großer Datenarchive so komplex?
Große Archive mit Petabytes oder Exabytes an Daten verteilen sich oft über mehrere Speicherbibliotheken, Standorte und Technologiegenerationen. Ohne zentralen Datenkatalog, einheitliche Metadatenindexierung und policy-gesteuerte Automatisierung ist eine effiziente Verwaltung praktisch unmöglich — und Daten werden faktisch unnutzbar (Dark Data).
Wie können Unternehmen archivierte Daten schneller finden?
Durch den Einsatz leistungsstarker Metadatenkataloge, die bereits bei der Archivierung automatisch strukturierte Indexeinträge erzeugen, sowie durch zentrale Suchoberflächen mit S3-kompatiblen APIs. Moderne Archivplattformen ermöglichen so die Suche über Milliarden von Objekten in Sekundenbruchteilen.
Was ist ein Active Archive und warum ist er besser als ein reines Backup?
Ein Active Archive geht weit über klassische Backup-Lösungen hinaus: Es ermöglicht direkten, schnellen Zugriff auf archivierte Daten und deren nahtlose Integration in aktive Workflows — etwa KI-Trainingspipelines, wissenschaftliche Analysen oder Broadcast-Produktionssysteme — ohne die Daten zuvor in teurere Primärspeicher zurückspielen zu müssen.
Welche Branchen profitieren besonders von skalierbaren Archivsystemen?
Branchen mit besonders hohem Bedarf an leistungsfähigen Langzeitarchiven:
- Wissenschaftliche Forschung und HPC-Zentren (z. B. Nationallabore, Universitäten)
- Medien- und Entertainmentproduktion (Broadcast, Streaming, Postproduktion)
- Gesundheitswesen und Life Sciences (PACS-Systeme, Genomdatenbanken)
- Öl- & Gasexploration sowie Energiewirtschaft (seismische Datenarchive)
- Nationale Sicherheit, Behörden und staatliche Archive
Warum ist langfristige Datenintegrität mehr als ein IT-Thema?
Datenintegrität über Jahrzehnte ist eine rechtliche, wissenschaftliche und wirtschaftliche Anforderung zugleich: Compliance-Vorschriften verlangen nachweislich unveränderte Archivdaten; Forschungspublikationen müssen auf reproduzierbare Rohdaten verweisen; und KI-Modelle, die auf korrumpierten Trainingsdaten basieren, liefern fehlerhafte Ergebnisse. Aktives Integrity-Monitoring mit kryptographischen Checksummen und offene Metadatenformate sind deshalb unverzichtbar.
Fazit
Die Verwaltung großer Datenarchive ist zu einer strategischen Kernaufgabe moderner IT-Organisationen geworden. Fünf zentrale Herausforderungen — Bibliotheksverwaltung, Datenauffindbarkeit, Workflow-Integration, Skalierbarkeit und langfristige Integrität — lassen sich mit modernen, modularen Archivmanagementplattformen lösen, die auf offenen Standards, intelligentem Metadaten-Management und hardware-agnostischen Speicherarchitekturen basieren.
Kontaktieren Sie Cristie Data, um zu erfahren, wie wir die größten Herausforderungen bei der Verwaltung umfangreicher Datenarchive und der Langzeitdatenspeicherung mit bewährten Technologien lösen können.